
Un entrepôt de données sans inventaire rend difficile de savoir quelles données protéger
Volumes massifs, sources hétérogènes, droits d’accès trop larges : les entrepôts de données multiplient les points faibles que les équipes doivent anticiper.
 Par
Élise Vandamme
En bref
- Les plateformes big data concentrent des données variées, ce qui accroît l’intérêt d’une attaque.
- Les droits d’accès trop larges et les copies oubliées figurent parmi les failles courantes.
- Chiffrement, journalisation et gouvernance se conçoivent dès l’architecture, pas après coup.
Une plateforme de big data rassemble en un seul endroit des informations qui, auparavant, vivaient dans des systèmes séparés. Cette concentration est sa force analytique, et aussi sa principale faiblesse : qui obtient un accès large dispose d’un panorama complet de l’organisation.
Pourquoi le big data change la nature du risque
Un système classique protège une base précise, avec un périmètre connu. Un environnement big data, lui, ingère des flux issus d’applications, de capteurs, de journaux ou de partenaires, puis les stocke dans des formats variés. Chaque source ajoute un point d’entrée potentiel, et chaque étape de traitement crée de nouvelles copies à surveiller.
La distribution du calcul sur de nombreux serveurs complique aussi la tâche. Les données circulent entre nœuds, entre stockage et outils d’analyse, parfois entre plusieurs fournisseurs de cloud. Une protection qui ne couvre que le stockage laisse sans défense les échanges internes.
Les failles les plus fréquentes
Plusieurs faiblesses reviennent dans ce type d’architecture :
- Des droits d’accès trop larges : pour faciliter le travail des analystes, on ouvre des espaces entiers plutôt que les seules données nécessaires.
- Des copies oubliées : jeux de test, exports temporaires ou sauvegardes persistent hors de tout contrôle.
- Une configuration par défaut conservée : des services mis en place rapidement restent exposés ou faiblement authentifiés.
- Des données personnelles mal repérées : sans inventaire, impossible de savoir quelles zones exigent une protection renforcée.
Ces défauts relèvent moins de la technique pure que de l’organisation. Ils naissent souvent de la vitesse avec laquelle un projet analytique est lancé.

Confidentialité et croisement des données
Le big data pose un problème particulier : la combinaison d’ensembles apparemment anodins peut permettre de reconnaître des personnes. Retirer un nom ou un identifiant ne suffit pas toujours à rendre une donnée anonyme, car le recoupement de plusieurs attributs peut ramener à un individu. La pseudonymisation réduit l’exposition, mais elle ne remplace pas le contrôle des accès.
Pour les données personnelles, le cadre réglementaire européen impose en outre de savoir où elles se trouvent, pourquoi elles sont conservées et qui peut les consulter. Un entrepôt sans cartographie rend ces obligations difficiles à tenir.
Les mesures qui réduisent l’exposition
La défense s’organise en couches, et aucune ne suffit seule.
- Classer les données selon leur sensibilité, afin d’adapter le niveau de protection.
- Chiffrer les données au repos et pendant leur transit entre les composants.
- Appliquer le moindre privilège : chaque utilisateur ou service n’accède qu’à ce que sa mission exige, avec une authentification forte.
- Journaliser et surveiller les accès pour repérer un comportement inhabituel, comme une extraction massive.
- Définir une durée de conservation et supprimer ce qui n’a plus d’usage.
Aucune de ces mesures ne garantit une protection absolue ; elles diminuent la surface d’attaque et la gravité d’un incident.
Une responsabilité partagée avec le cloud
Quand l’entrepôt de données est hébergé chez un fournisseur de cloud, la sécurité se partage : le prestataire protège l’infrastructure, tandis que l’organisation reste responsable de la configuration, des identités et des données elles-mêmes. Confondre les deux périmètres est une source d’erreurs classique. Sur ce point, l’analyse sur le big data et la sécurité informatique montre aussi que ces mêmes volumes servent à la détection des menaces.
Enfin, la sécurité des données massives repose sur les équipes autant que sur les outils. Les ingénieurs de données, les analystes et les responsables de la sécurité gagnent à travailler ensemble dès la conception, car corriger une architecture déjà en production coûte davantage d’efforts que la penser protégée dès le départ.
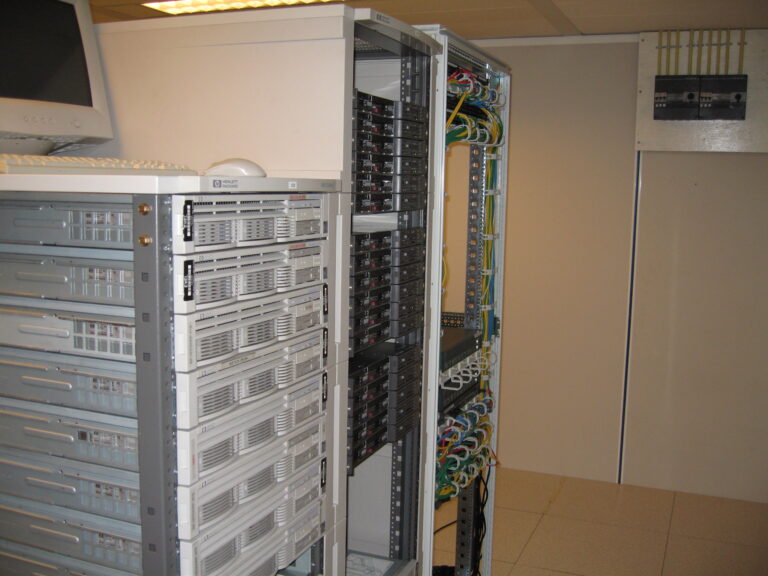
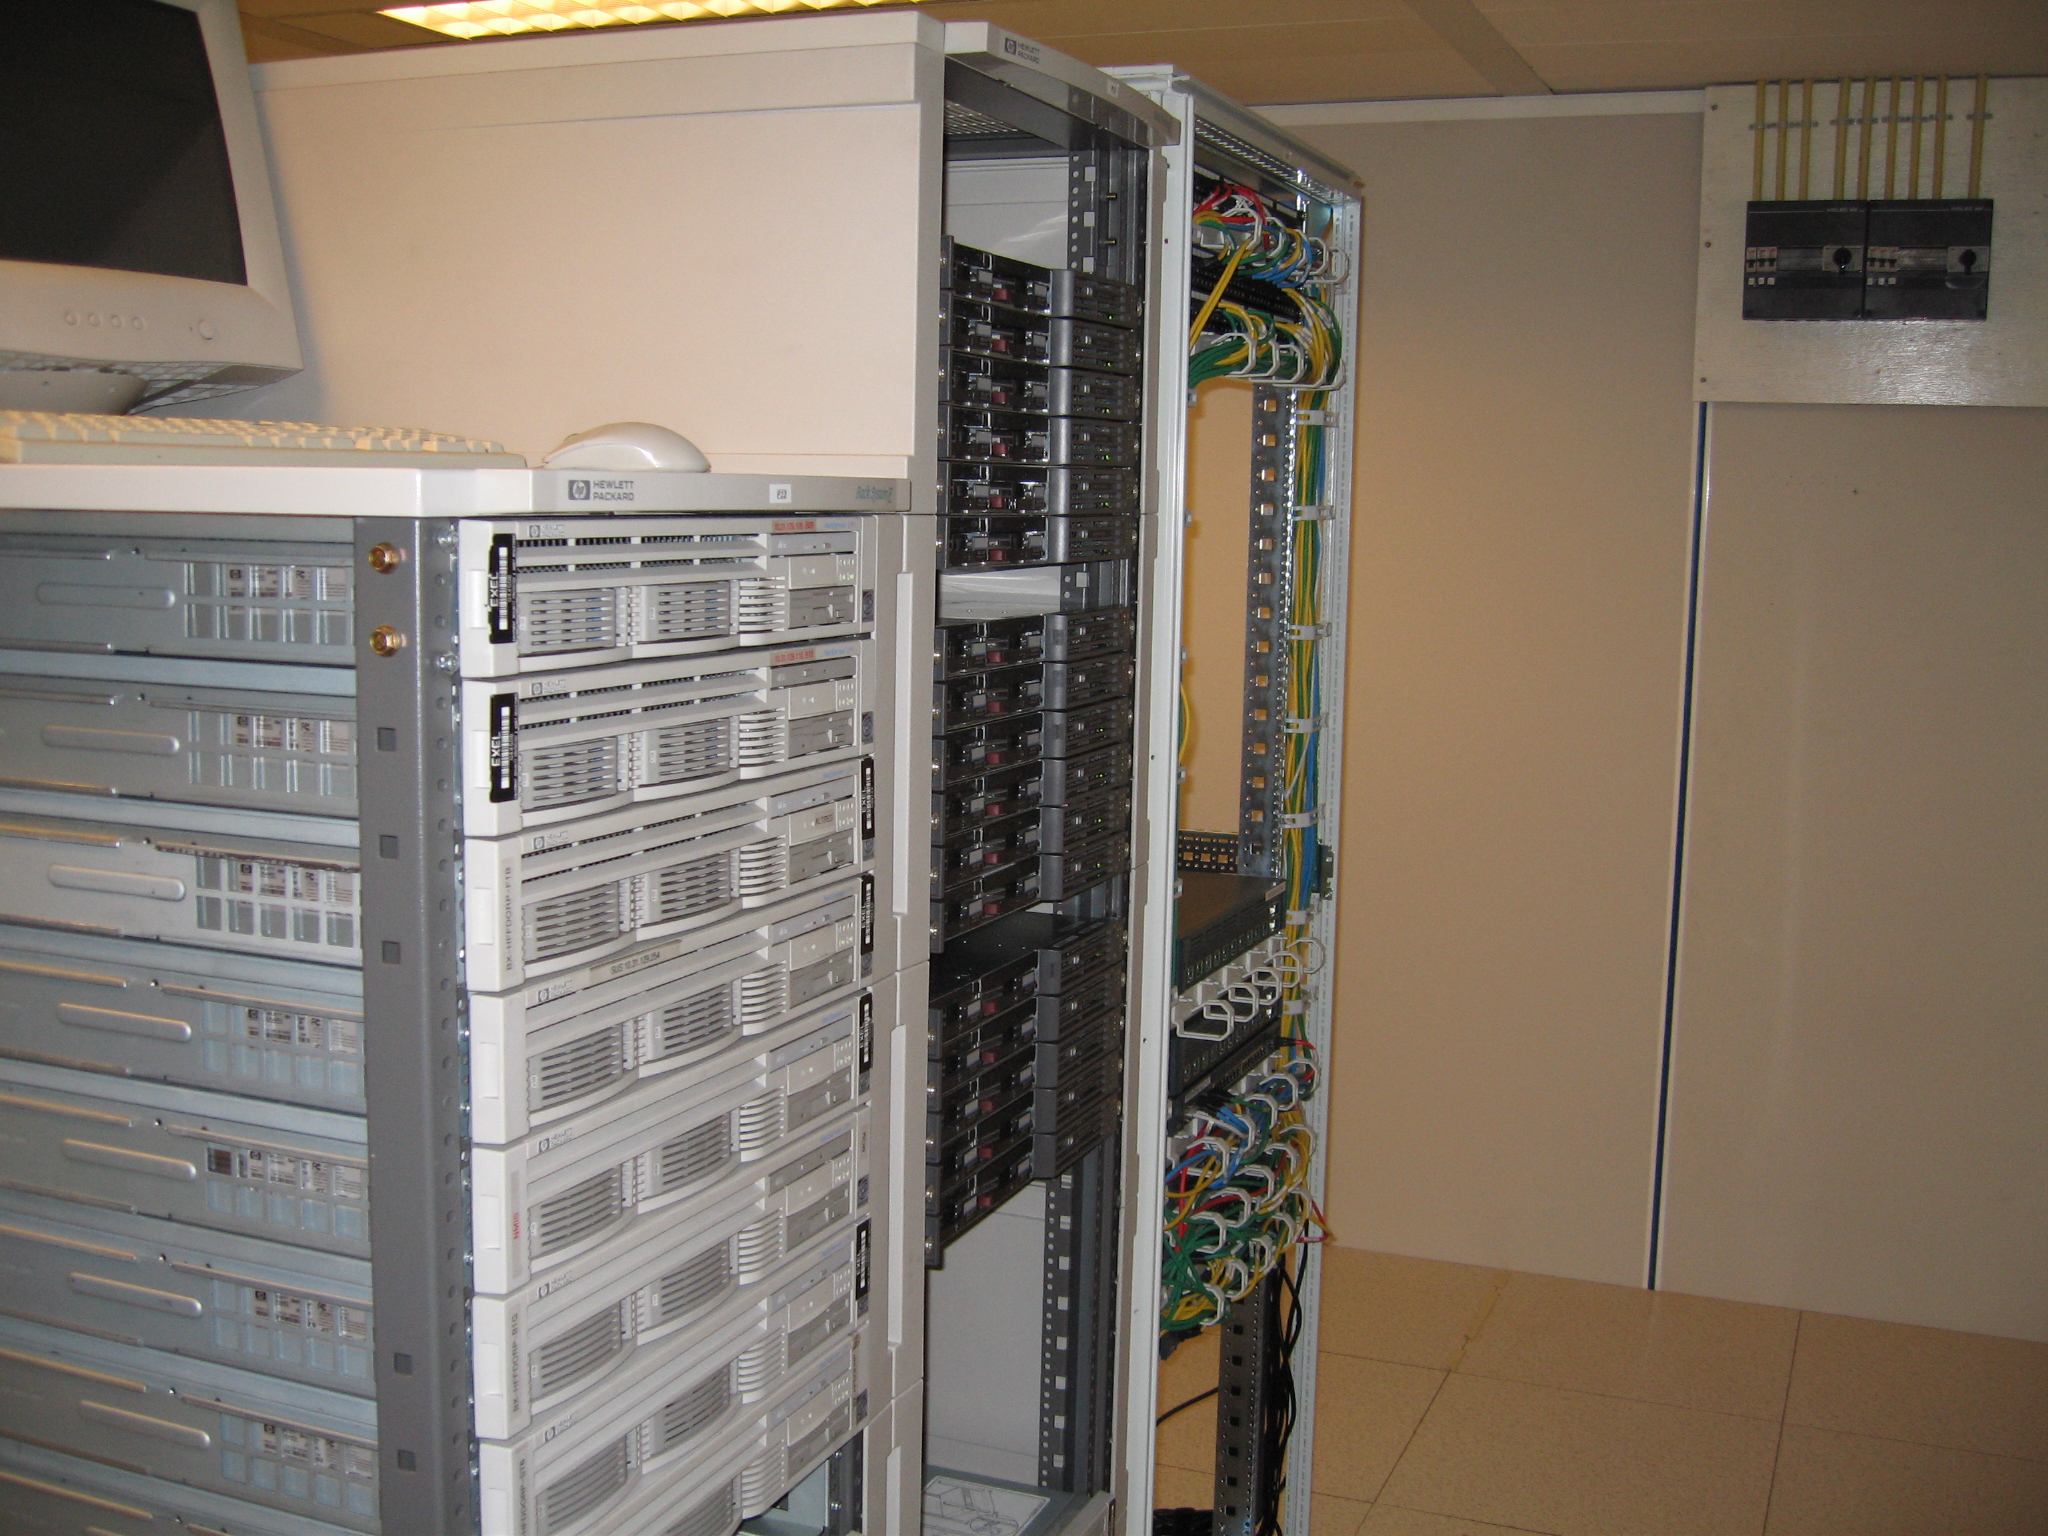
Photo : Jemimus / Wikimedia Commons, CC BY 2.0